
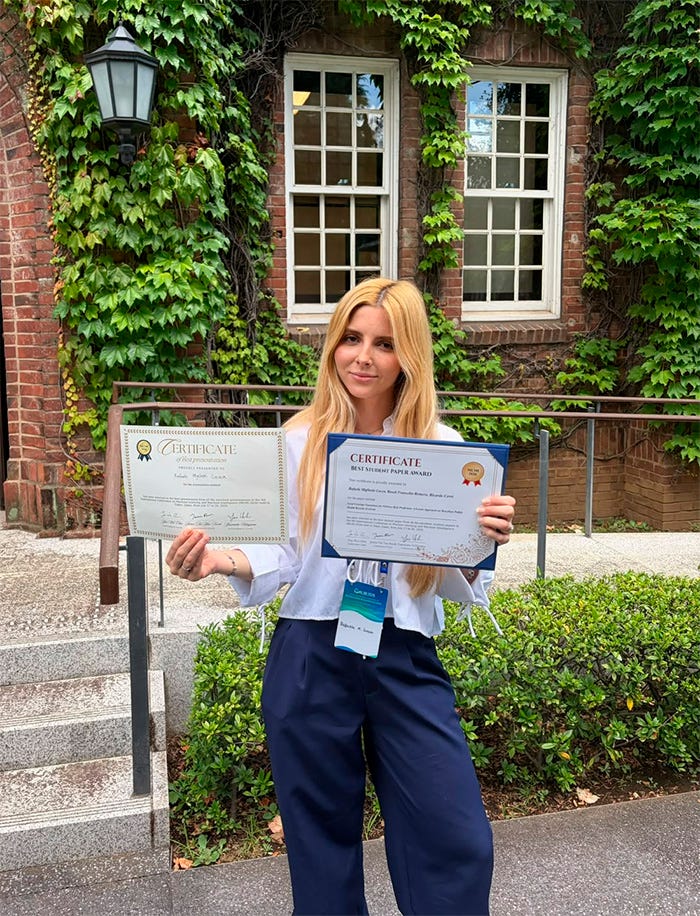
Uma pesquisa realizada no Instituto de Ciências Matemáticas e de Computação (ICMC) da USP aplicou técnicas de aprendizado de máquina para estimar o risco de mulheres sofrerem violência física, sexual e psicológica com base em dados públicos disponibilizados pelo Sistema Único de Saúde (SUS). O estudo foi premiado na 9ª Conferência Internacional de Aprendizado de Máquina e Inteligência de Máquina, realizada em Tóquio, no Japão, e também será apresentado no 41° Simpósio Brasileiro de Banco de Dados.
Desenvolvido pela aluna de doutorado Rafaela Miglinski Lucca, o projeto foi apresentado como trabalho final da disciplina Data Science and Machine Learning (Ciência de Dados e Aprendizado de Máquina, em português), ministrada pela professora Roseli Aparecida Francelin Romero, orientadora e coautora da pesquisa. O objetivo da disciplina é aprofundar o conhecimento sobre as técnicas de ciências de dados e aprendizado de máquina e sua aplicação em pesquisas científicas.
Calculando o risco
O estudo, que deu origem a um artigo ainda em fase de revisão por pares, partiu de duas questões: qual é o risco de uma mulher se tornar vítima de violência e qual é a chance dessas predições estarem erradas. Para responder a essas perguntas, as pesquisadoras aplicaram métodos de aprendizado de máquina e dados de violência contra a mulher, buscando identificar padrões e variáveis associados aos diferentes tipos de violência.
“Aplicamos diversos modelos de aprendizado de máquina aos dados de violência contra a mulher, pensando em três desfechos [violência psicológica, sexual e física], para tentar predizer e encontrar variáveis que ajudassem a detectar se uma mulher poderia sofrer violência ou não”, diz Rafaela.
A partir dos dados de casos de violência registrados no DataSUS – o Departamento de Informação e Informática do Sistema Único de Saúde – , os modelos foram treinados para identificar padrões e fazer estimativas. “Depois de treinado, o modelo recebe um caso novo e devolve uma probabilidade, algo como ‘há 78% de probabilidade de este caso envolver violência sexual’. Ele não dá uma certeza, e sim uma estimativa baseada no que já viu”, explica a doutoranda.
O DataSUS é uma plataforma de acesso público que reúne informações sobre a saúde da população brasileira. Entre os modelos testados, um dos destaques foi a regressão logística, método estatístico que estima a probabilidade de ocorrência de um determinado desfecho a partir de diferentes características. O modelo atribui pesos às informações, permitindo identificar quais variáveis mais influenciaram as previsões.
Apesar dos bons resultados, Rafaela Miglinski Lucca ainda questionava a confiabilidade das estimativas. Em uma segunda etapa, a pesquisadora utilizou o método de predição conforme para avaliar o grau de confiança das previsões.
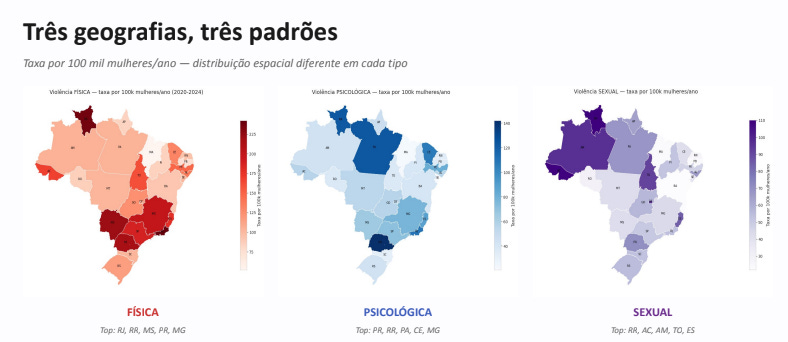
Mapa feito com dados disponíveis no DataSUS – Foto: Retirada do artigo
“É um conjunto de métodos que funciona como um teste de honestidade do algoritmo: antes de usá-lo, mede quantas vezes ele erra em um grupo de dados separado justamente para isso. Com essa medida em mãos, o modelo deixa de dar apenas uma resposta e passa a dizer também o quanto ela é confiável”, explica. “No estudo, o ajuste foi feito para que a resposta correta estivesse ali dentro em 90% dos casos.”
“A partir dos resultados desse primeiro modelo da regressão logística, continuamos conduzindo o processo aplicando o Locart, um modelo de predição de incerteza para subgrupos, para observar se essas predições feitas na regressão logística tinham sido confiáveis”, continua a pesquisadora..
Rafaela Miglinski Lucca mapeou, no Brasil, as áreas com maior índice dos três tipos de violência analisados. Para as pesquisadoras, o estudo pode contribuir para o planejamento de políticas públicas adaptadas às necessidades de cada região. “Por exemplo, se o governo federal quisesse implementar isso [o modelo] dentro das delegacias para saber se já deveria dar uma medida específica para aquele tipo de mulher ou se ela cai naquele tipo de variável”, explica a doutoranda.
O modelo permitiu analisar características associadas aos casos de violência. Entre os fatores identificados, estão menor nível de escolaridade, ausência de uma rede de apoio e a residência em áreas com pouco acesso aos serviços de saúde.
A idade também apareceu como uma importante variável nos casos de violência sexual, principalmente em mulheres mais jovens e crianças. Nos casos de violência psicológica, um dos aspectos observados foi reincidência das vítimas a hospitais e delegacias. De acordo com Rafaela, “algo marcante deste tipo de violência é não ter um bom desfecho, porque se a mulher tem que voltar a fazer o BO [Boletim de Ocorrência] tem uma reincidência, a violência segue acontecendo”.
Inovações e próximos passos
Esta é a primeira vez que o método Locart é aplicado a uma base de dados de vigilância em saúde e a uma questão social. Proposto em 2024, o método permite analisar a confiabilidade das previsões em diferentes subgrupos da população.
“Os métodos padrão de quantificação de incerteza garantiam 90% de acerto na média, e cumpriam isso. Mas quando olhamos por subgrupo, descobrimos um grupo de 18.326 mulheres, no desfecho de violência sexual, em que a garantia real era de apenas 44,7%. Com o Locart, subiu para 88,3%”, diz a doutoranda.
Na prática, esse resultado mostra que um modelo pode apresentar indicadores gerais de confiabilidade e, mesmo assim, produzir previsões menos confiáveis para determinados subgrupos. “Um modelo pode não ser confiável exatamente para o grupo mais vulnerável e ninguém perceberia, porque a média esconde. Nosso argumento é que essa verificação por subgrupo deveria ser uma etapa obrigatória antes de qualquer modelo desse tipo ser usado em política”, destaca Rafaela.
A análise também permite construir informações sobre o contexto e os locais associados aos diferentes tipos de violência, etapa que integra o processo inicial de modelagem. Além de uma possível aplicação em larga escala, as pesquisadoras continuam os estudos sobre o novo método em parceria com outras universidades.
Vencedor dos Prêmios de Melhor Artigo e Melhor Apresentação na Conferência Internacional de Aprendizado de Máquina e Inteligência de Máquina de 2026, o artigo completo aguarda publicação na Springer Nature. No Brasil, a primeira etapa da pesquisa foi submetida ao 41° Simpósio Brasileiro de Banco de Dados e será apresentada em setembro.
Matéria: Carolina Mattos | Jornal da USP.